感謝各位朋友的支持,2026 / 10 / 31(六)的《統合分析工作坊》,現已報名額滿。
問:選舉期間有好多份民調,每一份說的都不太一樣。我該相信哪一份?還是應該合在一起看?
答:(蔡依橙)
這是孩子最近問我的問題。
我聽了覺得很有意思,因為統合分析這種研究方法當初會被發展出來,就是為了回答這種問題。
每一份民調,其實就像一篇研究。
依《公職人員選舉罷免法》第 53 條,選舉期間發布民調,必須同時載明負責調查單位、主持人、辦理時間、抽樣方式、母體數、樣本數、誤差值及經費來源。
這就像一篇研究必須寫清楚它的 Materials and Methods:誰做的、誰出錢、什麼時候做、怎麼抽樣、樣本多大、誤差多少,全部攤開來接受檢視。
做統合分析時,我們也會用文獻評讀的眼光去看每一份:抽樣方式有沒有問題?題目會不會引導?有沒有可能產生偏誤?這就是所謂的 risk of bias。
問:我的統合分析最後收了 9 篇進入分析,但 outcome 量表分成兩種,一種測「滿意度」(7 篇),一種測「品質」(2 篇)。因為篇數的關係,我打算把兩種合在一起看,直接在文中說明。或者會建議用分組分析來處理嗎?
答:(蔡依橙)
這個有幾種做法,但最重要的問題是要先思考:滿意度跟品質到底一不一樣?這兩個在概念上是差很多,還是其實相關性很高?
這牽涉到你對這個領域的熟悉度,因為有些領域會認為,滿意度跟品質根本不一樣。但有些領域則是滿意度跟品質其實非常高度相關。
「根本不一樣」的意思是,有些人的品質不好,但是滿意度很高;或者品質很好,但滿意度卻不高。如果我們覺得這種狀況其實很明顯,那麼直接專注在滿意度那 7 篇去做統合,會是比較乾淨的做法。
但如果你個人的直覺,加上文獻上也支持,品質跟滿意度基本上可以混用,那就兩個合在一起做統合分析,並用一個更上位的名詞把它們涵蓋起來。(例如 well-being)
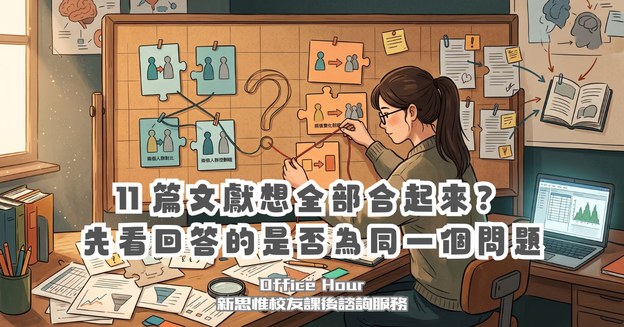
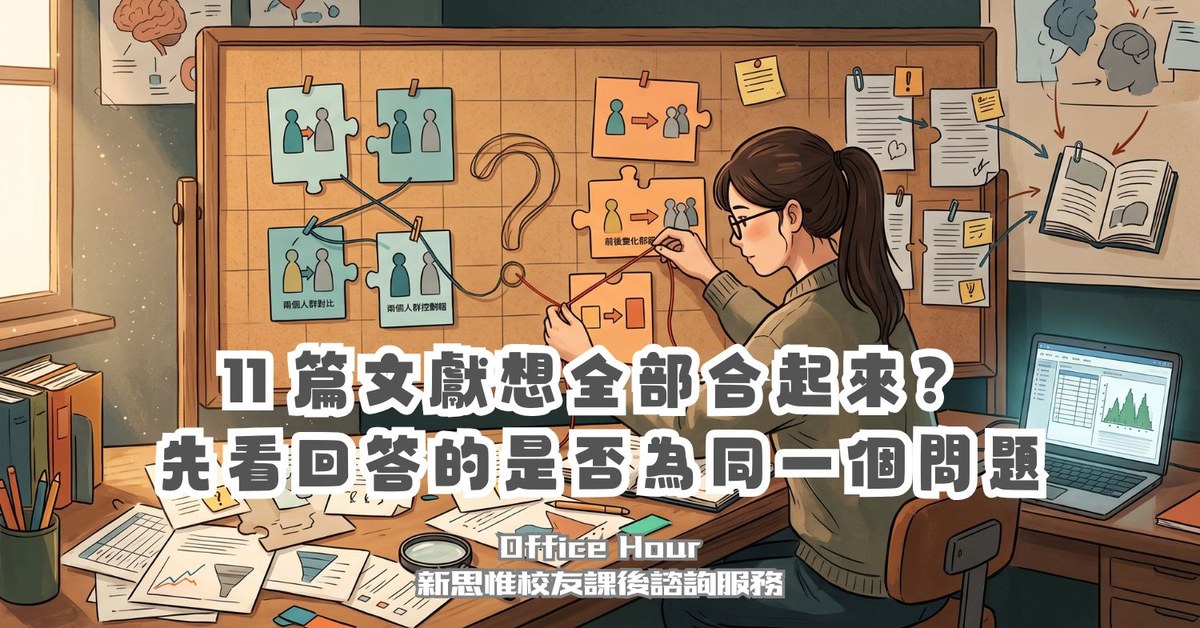
問:我在做一個介入型主題的統合分析。從一百多篇文獻篩選到最後,能放進 CMA 的只剩這些:一種是「組間比較」,同一個疾病族群,一組有介入、一組沒介入,四篇;另一種是「組內比較」,同一個疾病族群比較介入前後,而且是拿介入後的數值去跟一般族群比,三篇;剩下四篇因為沒有完整的 mean 和 SD,只能做 narrative synthesis。總共十一篇。我想全部整合起來,讓故事更完整。這樣合理嗎?組間和組內可以合在一起分析嗎?(題目經模糊化處理,但保留精確概念。)
答:(蔡依橙)
先講一個關鍵:有對照組的「組間」研究,跟這種「組內前後測、再拿介入後去跟一般族群比」的研究,是沒辦法合在一起做統合的。
不只是統計上不建議,更根本的是,它們回答的臨床問題其實不一樣。
組間那幾篇問的是:「同一個疾病族群,有介入的,是不是真的比沒介入的好?」
組內那幾篇問的是:「這個疾病族群透過介入,介入後的表現能不能拉近跟一般族群之間的差距?」
你可能覺得,這兩個不都在講「介入有效」嗎?但在科學概念上,它們是兩件事。一個是證明介入本身有效,一個是證明介入能縮小疾病族群跟一般族群的落差。混在同一張森林圖裡,讀者會混亂,審閱者也會有疑慮。
作者:臺中榮總 過敏免疫風濕科 陳韻文 醫師
2024 年,我在美國哈佛大學醫學院附屬布萊根婦女醫院,過敏及臨床免疫科擔任一年期研究員時,參加指導教授為 Fellows 舉辦的「Introductory Course for Allergy and Immunology Fellows Program」。在職涯規劃分享與諮詢的環節,來自奈及利亞的 Ayobami T. Akenroye 醫師給 Fellow 們一個我印象深刻的建議:
「A review article or meta-analysis in the field you are interested in.」
她鼓勵年輕醫師,可以從自己有興趣的領域,嘗試 review article 或 meta-analysis。過去我一直以為這兩種文體是比較資深的研究者才有能力駕馭,也因為這句話,我決定回台灣後要把這兩種文體學起來。
作者:童綜合醫院 腎臟內科 陳昶旭 醫師
這次參加《統合分析工作坊》,對我而言並不是第一次接觸統合分析。多年前曾經實際做過 network meta-analysis,因此對 systematic review、文獻搜尋、資料整理以及統合分析的基本流程並不陌生。
不過,這次課程還是讓我有不少新的收穫,尤其是在 AI 工具逐漸進入研究工作的現在,很多過去需要花大量時間摸索的步驟,已經可以用不同的方式來進行。對我來說,這次最有價值的部分,不是重新學習統計方法本身,而是重新思考現在要如何更有效率地完成研究題目的設定、文獻搜尋,以及後續投稿的整個流程。
作者:童綜合 腎臟 張家華 醫師
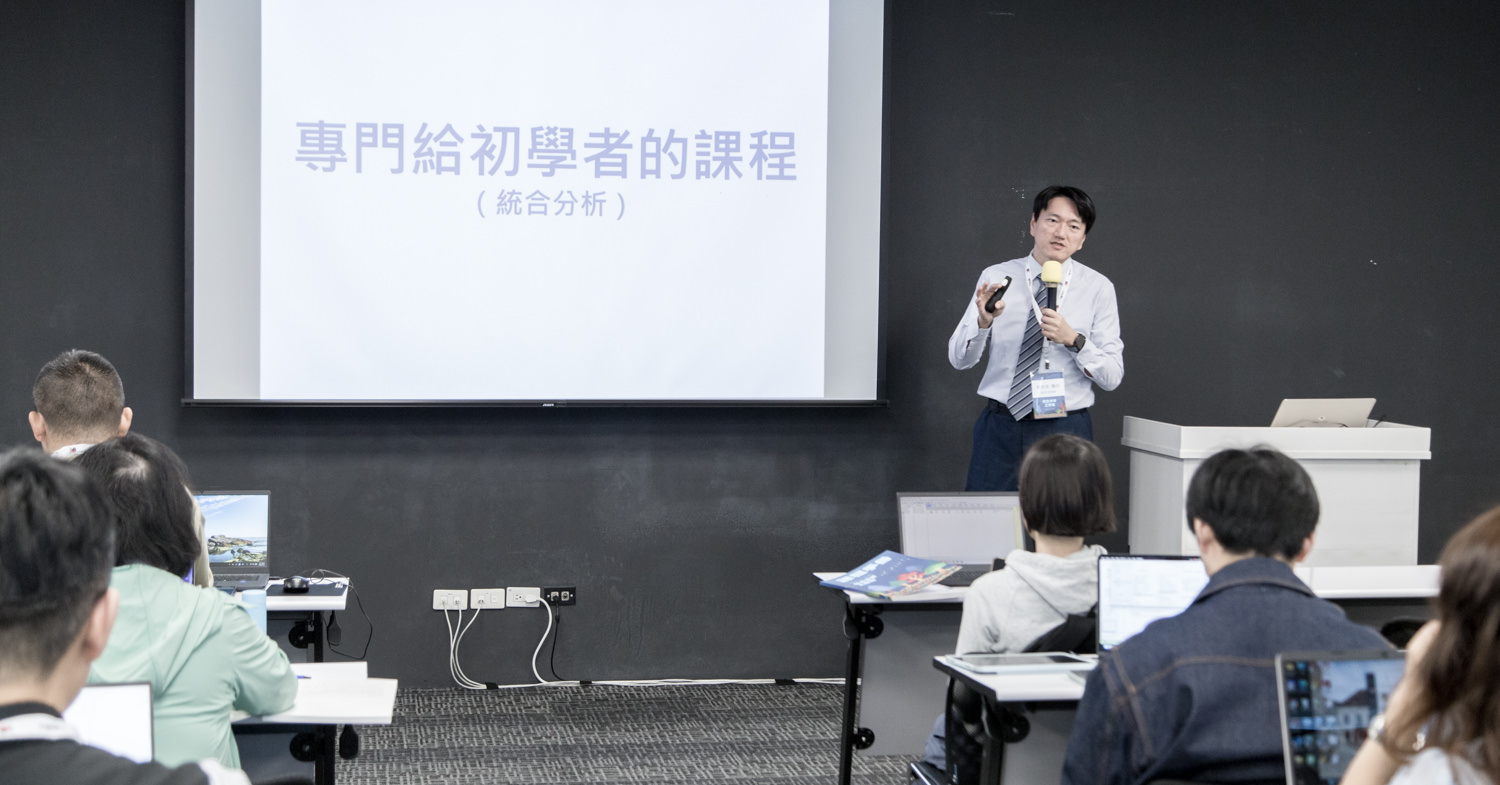
平常在臨床工作中,遇到治療選擇或研究結果不一致的時候,我常會找統合分析來看。但看別人的文章,跟自己從頭做一篇,還是兩回事。
一直有想學的念頭,也有幾個感興趣的題目,只是想到文獻搜尋、資料整理、統計和寫作,就不知道該從哪裡開始。這次參加新思惟的統合分析課程,最主要的期待,就是把這些零散的概念接起來,弄清楚自己接下來可以怎麼做,剛好遇到學長邀請一起參加,就來看看。
作者:國立陽明交通大學 醫學系 黃照文 同學
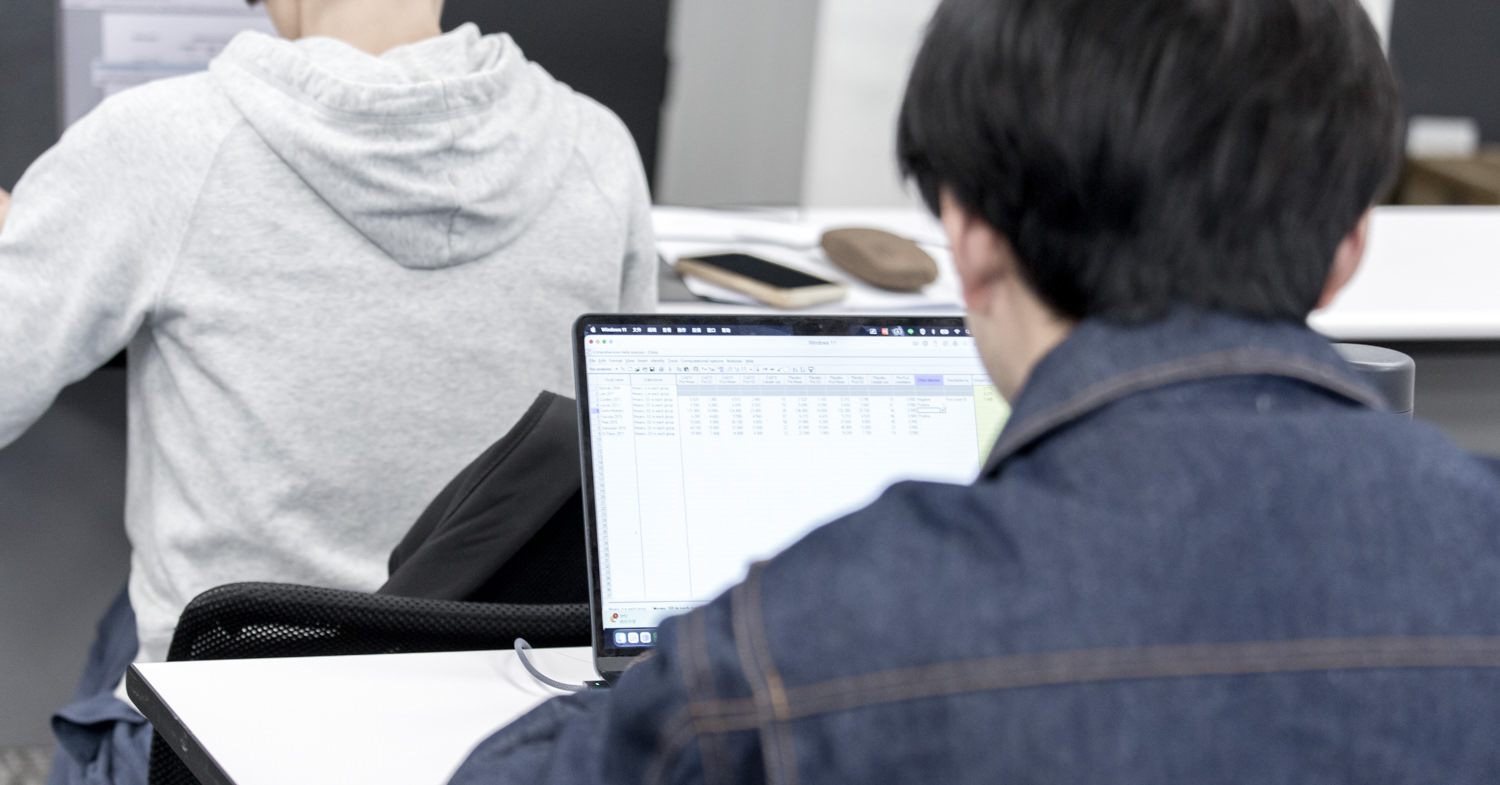
這次會報名參加新思惟的《統合分析工作坊》,最主要的原因,是因為近期開始接觸 Meta-analysis,希望能學習如何製作 forest plot,以及統合分析中常見的各式圖表。其實在決定報名之前,我幾乎沒有太多正式的研究經驗,許多對其他人而言可能屬於研究入門的基礎知識,對我來說都是第一次接觸。
因此,在正式上課前,我其實非常擔心自己會不會因為基礎不足而跟不上進度,甚至一度擔心課程內容會過於艱深。不過實際參與完整個工作坊後,我發現這樣的擔心其實是多餘的。
作者:高雄市茄萣區 成功國小 林俊仰 老師
教育領域相關研究也可以用「統合分析(Meta-analysis)」(教育、心理及社會科學界又稱「後設分析」)來做嗎?答案不僅是肯定的,而且這片藍海還有許多主題尚待開發。
想做研究,但收案要等、IRB 要申請;臨床與工作把時間切得零碎,題目在腦中想了好幾年,始終沒有踏出第一步。
統合分析,不需要經歷這些困難。
「本來還想做 RCT 的研究論文,原來是這麼困難,感謝老師先教我們初學者可以完成的 SCI 等級論文,關於資料擷取是我課外要學習的方向。」
許多人的第一個研究構想,是自己收案做 RCT 或世代研究;真正開始評估後才發現,收案、經費、人力、時程,每一關都是大工程。
所以課程帶你先走一條初學者就能完成的路:以既有文獻為材料,做出 SCI 等級的論文。當第一篇成功發表,履歷有了成績、心裡有了底氣,再回頭挑戰更大的研究設計,資源與合作都會更容易到位。
關鍵字怎麼下、資料庫怎麼選、同義詞怎麼涵蓋,每個環節都影響最後能收進幾篇研究。
課堂中,講師把 AI 工具輔助搜尋的實際做法攤開來示範:哪些步驟可以交給 AI 加速、哪些判斷必須自己把關、AI 給的結果要怎麼驗證。工具與方法學互相搭配,研究的起步,比過去快上許多。
「謝謝籌備團隊與講師們的用心規劃!經過今天的工作坊,感覺自己寫論文的信心和鬥志大大增加了!」
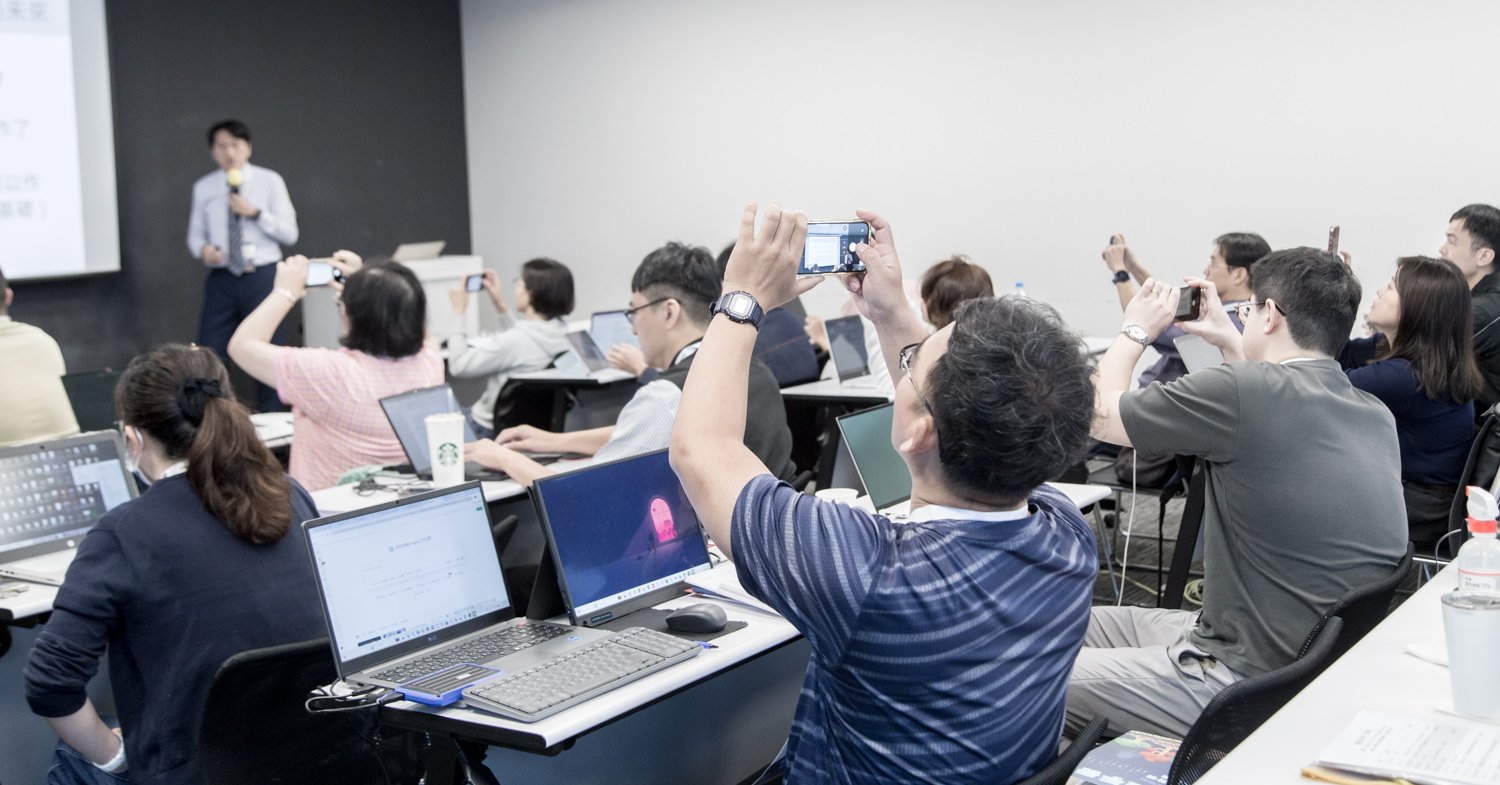
互動實作時間,你會在自己的電腦上,用 CMA 跑出投稿等級的森林圖,卡關的地方,講師與助教隨時到身邊協助。當圖表真的從自己手中產出,信心與鬥志,自然就長出來了。
統合分析不需要 IRB、不需要病歷、不需要龐大的團隊,只要電腦跟網路,就能寫出一篇有品質、有系統的論文。在臨床與研究時間都被切碎的現實裡,它是高 CP 值的學術產線。
從新手到能獨立完成研究,《統合分析工作坊》幫你打好基礎、補齊關鍵技能,讓你的能力拼圖完整成型,研究路上更有競爭力。一年發表三篇,打造自己的學術產線!
如果你的研究是教育領域,或是屬於很難找到對照組的領域,但有盛行率的資料,也可以寫出統合分析論文喔!
對網絡統合分析、內科系研究、外科系研究、個案報告等文體,以及想要走向國際有興趣的,我們也有相對應的課程。主題不同,內容一樣豐富優質,一樣都有大量校友產出成績。
孩子整天滑手機、看短影音,做家長的卻不知道怎麼引導?《AI 素養教育工作坊》專為家長設計,蔡依橙醫師分享如何把 AI 與數位工具從「玩具」轉變為孩子的「學習工具」,從小幫助孩子建立自律與自學能力,把 3C 從讓人擔心的源頭,變成解決學習困境的助力。
臨床做得很好、研究也持續累積,但網路上的能見度卻像透明人?在 AI 文章氾濫的時代,光是「會寫」已經不夠,更要讓搜尋引擎與 AI 都認得你的真實專業,產生長期、被動的曝光與信任。《AI 時代的個人品牌工作坊》是一日實戰課,帶你當天就完成自有網站並發表第一篇文章,整合 Claude Code 與 GEO 策略,把屬於你的專業曝光渠道建立起來。
課後卡關不用再怕無人能問,新思惟推出每週一次蔡校長的 Office hour,提供課程校友線上諮詢,陪著學員走完成功發表的最後一哩路!
以下,一起回顧當天熱情學習的照片記錄。
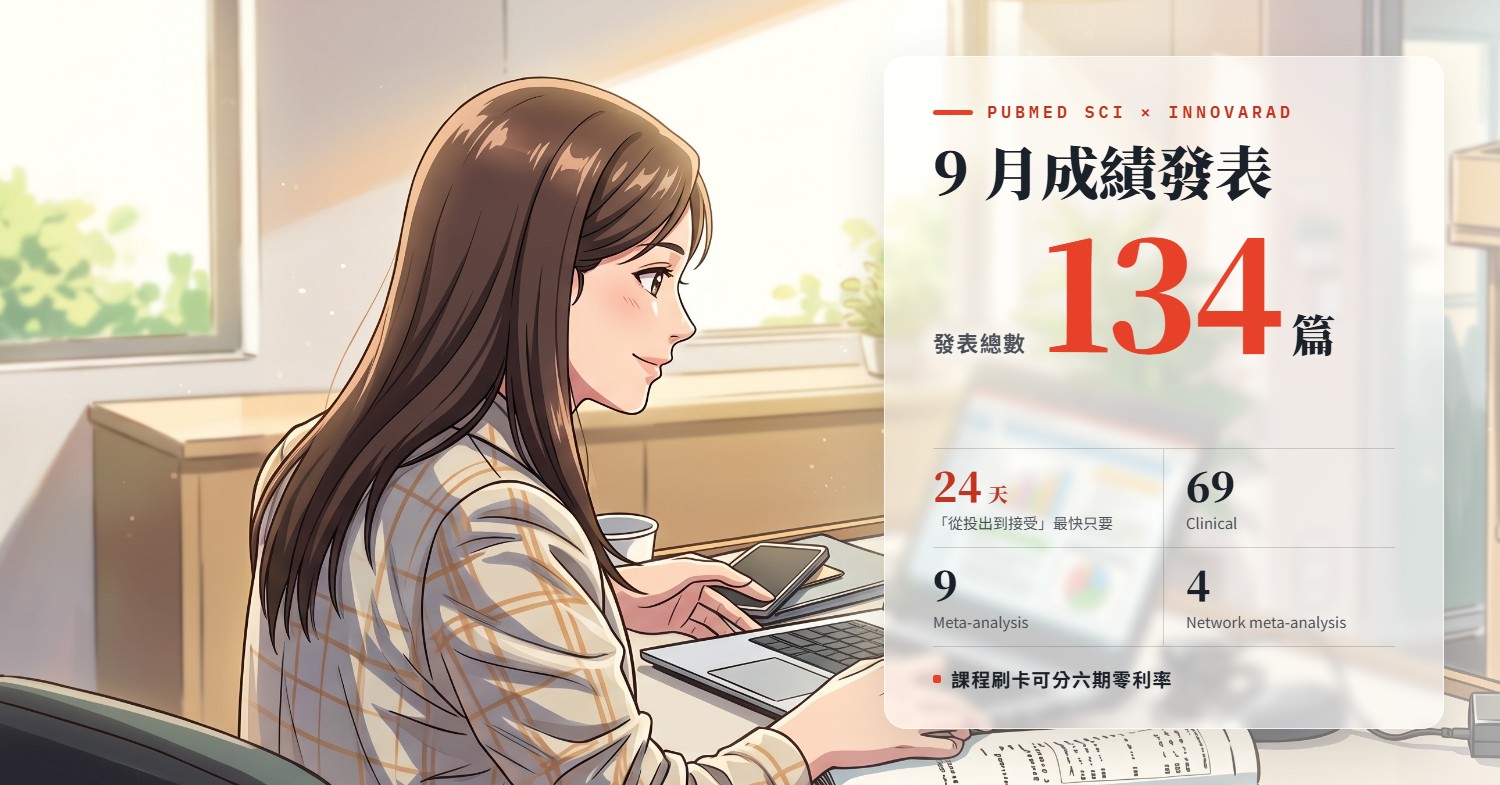


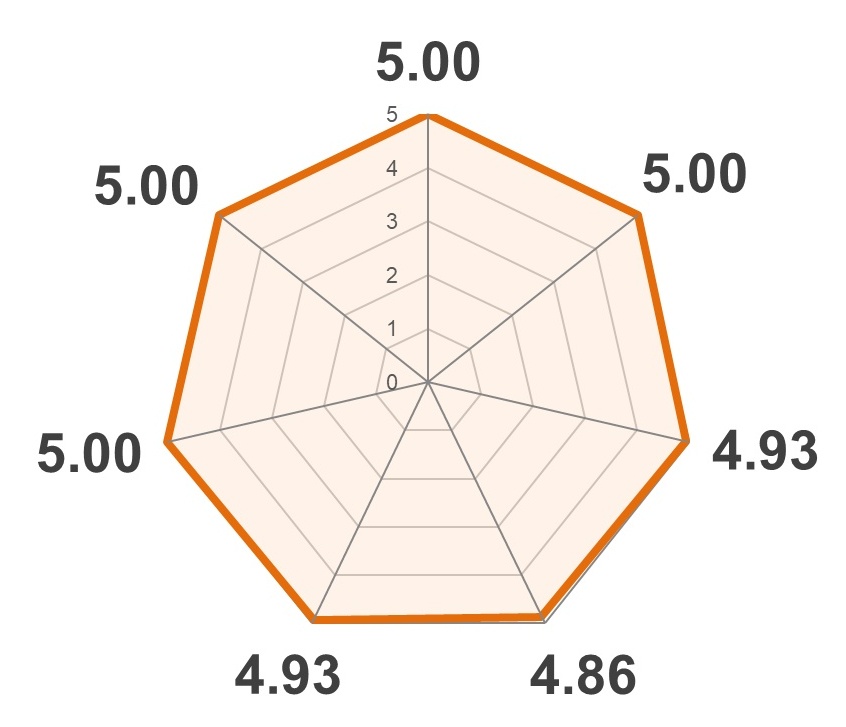
感謝各位給籌備團隊的匿名回饋,所有學員給籌備團隊的滿意度,全部分數皆高於 4.86 分!謝謝大家給予肯定與建議。
根據統計,本次學員組成如下:
感謝大家課後的匿名手寫回饋,內容非常精彩,包括 AI 搜尋帶來的啟發、CMA 軟體的使用技巧、課程手冊,以及寫論文的信心和鬥志大大增加,顯示不管是研究初心者或是資深研究者,都能在工作坊中有豐富的收穫,很榮幸新思惟的課程能給您前所未有的突破和啟發!
除了統合分析,想要無資源起步,現在又多一個選擇囉!網絡統合分析,讓你工具更多、產線更多。
對於內科系研究、外科系研究、個案報告等文體,以及想要走向國際有興趣的,我們也有相對應的課程。主題不同,內容一樣豐富優質,一樣都有大量校友產出成績。
自己的臨床做得很好,研究也發展不錯,但網路上的存在感卻形同透明?期待在 AI 時代生存得更好,讓自己的專業和成績被看見,也想協助孩子正確運用新的科技,網路個人品牌課程與素養教育課程可以幫助你!
所有工作坊,都有售後服務喔!詳細辦法,請參考 Office Hour 頁面說明。


「真的有辦法在一個中午的時間,就做出整套 SCI 的圖表嗎?」這幾乎是每個梯次的同學來到課堂上,都會有的疑問。
上午聽完三堂課之後,同學們已經能感受到,這裡的教學是以學生為中心,並且是以讓大家能夠發表 SCI 為目標所設計的。因此,中午開始動手做的時候,大家對課程本身已經有了信心。
也因為這樣,大家在繼續動手的過程中,發現這樣規劃的教學如此有效。每個人的成就感,以及對整個學習過程的良好體驗,都是相當好的結果。在互動實作結束之前,所有人也都完成了整套 SCI 期刊等級、可以用來投稿的圖片,非常不錯。
以下,一起來看看老師們還想向各位建議的小細節,以及得獎同學的作品。
張凱閔醫師 / 蔡依橙醫師
2026 年 11 月 21 日(六)9:00a – 4:40p
集思台中新烏日會議中心 台中高鐵站旁
醫療 / 非醫療都有題目寫 / 免寫程式
台中高鐵班 / 台北班,同步開放報名!
有臨床觀察、有想法,卻沒時間收案、IRB 跑不完,也找不到願意帶的老師,研究始終起不了步。統合分析(Meta-analysis)剛好不需要這些。
它用的是已經發表的文獻,收案、IRB、等資料累積,全部省下來。會用 Word、Excel 就能學,不必寫程式,課後回家就能動手。
課堂上,你會在自己的電腦親手做出一整套投稿等級的圖表。AI 也會教:找題目、潤稿可以交給它,數據萃取這類容易出錯的環節,會告訴你怎麼自己把關。課後卡關,有 Office Hour 可以問。
2025 年,新思惟校友全年發表 1034 篇,原創論文中每 5 篇就有 1 篇是統合類。不只醫師,護理師、物理治療師、營養師、藥師,以及公衛、教育、心理領域的研究者,只要題目有「介入」與「結果」、領域裡有累積的文獻,就做得出來。
博士班要畢業論文、研究所要 SCI、職涯要代表作,統合分析是資源門檻最低、方法論也站得住腳的起點。
學術發表這件事,不必等到資源齊全才開始。
在 2025 年,新思惟校友月發表數屢破 100 篇,全年產出 1034 篇。為什麼大家產量激增?因為越來越多的研究者都在開發「第二、第三產線」。
臨床研究常受限於 IRB 與收案速度,而「統合分析」則是突破限制的關鍵。2025 年校友發表的原創論文中,每 5 篇就有 1 篇是統合類文章! 這是最穩定、最可控的學術投資。
🧭 免收案,免 IRB,臨床直覺即價值。
不用求人分數據,只要有公開文獻與正確方法,就能把你的臨床觀察寫成 SCI 論文。
🤖 AI 協作,把力氣用在刀口上。
教你如何與 AI 腦力激盪,在 PubMed 快速過濾熱門題目。文法檢查、語句潤飾這些瑣事交給 AI,你的心力,留給臨床討論。
📊 免寫程式,直覺做出頂尖圖表。
互動實作時間,你會親手操作專門軟體,現場產出投稿等級的森林圖、漏斗圖。遇到問題助教隨時在側,保證從 0 到 1 真的做得出來。
🛠️ 最挺你的 Office Hour,課後寫作不卡關
上完課,回家開始寫,才會遇到真正的問題。新思惟提供課後提問機制,投稿過程中 Reviewer 的各種意見,都可以來問。
✅ 選題雷達: 快速判斷主題 CP 值,確保有發表機會。
✅ 數據整理: 排除低品質研究,建立系統化資料夾。
✅ 視覺呈現: 製作符合頂尖期刊規範的統計圖表。
✅ 回覆技巧: 如何把 Revise 變成 Accept 的關鍵對話。
你是來自醫療、教育、運動、心理、護理、營養、公共衛生、管理,只要你想解決臨床疑慮,研究題目,有「介入」與「結果」,統合分析就能幫你提升發表效率與品質!
過往參與這門課程的校友,不僅成功發表了論文,還有不少人在短時間內進入論文量產的階段。無論是醫學背景的專業人士,還是非醫學領域的學者,都能夠從中獲益。
《統合分析工作坊》,讓學術研究變得簡單可行。資源不多、又需要發表成績的研究者,很適合從這裡起步。
問:正在起步統合分析,想請教一個文獻評讀的問題。我把 RCT 與 systematic review 的評讀標準匯入 AI 工具,再把要評讀的論文傳上去,請它依標準評讀。這樣操作合適嗎?會有什麼盲點?因為有些論文頁數真的很多,很難全部人工評讀,如果還要從 reference 回溯做二次搜尋,更是困難,所以想借 AI 的力量協助。
答:(蔡依橙)
可以這麼做。但在你把結果貼進表格之前,先知道它會給你什麼樣的東西。
我自己的經驗是,AI 跟我評的真的差很多,而且會偏嚴格,評出來通常是 some risk 跟 high risk 一堆。
這其實不難理解。文獻評讀本來就有主觀成分,每個人評起來本來就不會一樣,甚至你叫 AI 今天評跟明天評,它也不見得會給你一樣的結果。
所以比較實際的做法是:用 AI 先跑一輪,然後你自己看,覺得「這篇怎麼會 high risk、some risk 這麼多」的時候,就針對你懷疑的那幾項回去查原文。
這一步不能省。表格上掛的是你的名字,審閱者問到某一項為什麼這樣評,要答得出來的人是你。
問:我找的題目是比較不同術式的效果差異,這個主題應該還沒有人做過,但相關的比較性研究很少,湊到最後只有 5 篇,而且全部是 retrospective。我自己先做了森林圖,結果是顯著的(p = 0.018)。但接著遇到兩個問題:第一,敏感度分析發現拿掉其中一篇之後就不顯著了,信賴區間跨過中線一點(p = 0.07),discussion 該怎麼敘述比較恰當?第二,如果要做 subgroup analysis,因為篇數少,會變成 2:3 甚至 4:1 的狀況,這樣還適合做嗎?
答:(蔡依橙)
先講一個前提:只有 5 篇的統合分析,本來就是「初步方向」,不是定論。這不是你的問題,Cochrane 自己的統合分析,中位數也才 3 篇。審閱者看到 5 篇,心裡本來就不會期待一個很確定的答案,他們要看的是你有沒有誠實把不確定寫出來。
因為篇數少,拿掉最強的那一篇就變不顯著,這其實很常見。有人統計過 Cochrane 的統合分析,三分之一只要改動五個以下病人的結果就會翻盤,所以這不是失敗,是提醒你結論要寫得比 p = 0.018 看起來的更保守。
具體來說,discussion 盡量不要寫「趨勢接近顯著」。一般期刊可能還好,但如果遇到專業的統計審閱者,會很不喜歡這種寫法,因為有人算過,接近顯著的 p 值再加資料之後,並不見得真的就會往顯著邁進。
比較安全的寫法是描述事實:五篇的效果方向一致,合併結果顯著;拿掉某一篇後,效果估計值仍偏向有效,但信賴區間跨過無效線,代表目前證據的精確度受限於篇數,需要更多研究確認。這樣寫,你沒有多說,也沒有少說。
英文可以這樣寫:Although the pooled estimate favored [intervention], the leave-one-out sensitivity analysis showed that the effect was no longer statistically significant after excluding [Study], with the point estimate remaining in the same direction. Given the small number of included studies, these findings should be regarded as preliminary; larger comparative studies are needed to confirm the observed direction of effect.

問:看到您先前電子報提到,現在很多出版社把工作交給低成本外包商處理,剛好有感而發想請教您。
我有一篇 SCI 登在某大型出版社,要付兩千多美金的 APC。我付完之後,出版社可能因為時間差還沒收到款,就寄信叫我再付一次,我就傻傻地又刷了一次,結果刷了兩筆。
現在對方的員工跟我說會退款,但拖拖拉拉說要等六週。我很怕他們拖到最後沒有退款。我應該再等一等,還是想辦法聯絡更高層?
答:(蔡依橙)
這件事要很小心,收到的 email 來源要非常仔細檢查,因為這是常見的詐騙。


問:最近一篇 SCI Q1 被接受後,期刊社在 production 階段把部分圖表和內容說明刪掉了。我們 proof reading 時提出修正,但文章正式上線後,發現這些修正並沒有被正確更新,寫信給原本的窗口也沒人回應,直到打電話給出版社總部才開始有人處理。這種狀況,適合正式寫信給 editorial office,要求確認責任歸屬、並提供原本負責的 production 人員姓名嗎?未來投稿同一家出版社,可以要求迴避同一人嗎?
答:(蔡依橙)
這種狀況很常見,這幾年不少人都回報過類似經驗。
現在許多大型出版社的 production 流程大幅外包給少數幾家超大型供應商,通常是懂英文但人力超級便宜的國家,他們開出來的價格便宜到非常驚人。
這在討論區跟媒體也多有報導,proof 改六輪、整段文字被刪、代名詞被換成數字、必要的連接詞被移除、數學符號排版錯亂,最後出版版本仍留有未修正的錯誤,都有。
也有擔任期刊主編的人證實,proof 階段確實會冒出離奇又前後不一致的錯誤,而且連他都懷疑,供應商把校對工作丟給還不成熟的自動化系統,卻沒有讓人力充分把關。更關鍵的是,期刊編輯往往也沒有選擇供應商的自由,這是「出版集團」層級決定的事。


作者:蔡依橙
常被問到,「用 AI 來做研究,到底可不可以?」
現在工具很多,從問答型 AI,到能自己跑流程的 AI agent,也包括各種用 AI 打造查詢介面的資料庫工具,甚至網路上大量免費分享的 skills。這些東西,究竟能不能拿來當研究工具?
有人說「AI 會出包」,有人說「會出包那是你不會用」,有人說「你看我這樣很快就生出整篇」,也有人說「你那個拿去投稿會出事」。到底哪個對?
這幾個月,只要有人提過,我就去實際使用並感受。歸納起來,我建議一個不錯的思考架構。
任何 AI 工具,在使用之前,都該先針對「自己想完成的那件事」,思考一下以下四個等級,看看你需要多高的要求。這四個等級,由低而高分別是:可行、可控、可重現、可負責。